
robots.txt 작성법: 문법·예시 파일·AI 크롤러 설정까지 (2026년)
robots.txt는 검색엔진과 AI 크롤러에게 “이 사이트에서 어디까지 가져가도 되는지”를 알려주는 텍스트 파일입니다. 이 가이드는 홈페이지를 운영하는 마케팅·총무 담당자와 개발자를 위해 문법, 구글과 네이버의 차이, noindex와의 차이, GPTBot 같은 AI 크롤러를 허용할지 막을지 판단하는 기준, 그대로 고쳐 쓸 수 있는 기업 홈페이지 예시 파일까지 한 번에 정리합니다. 사이트맵 파일을 만드는 방법은 별도 글에서 다루고, 여기서는 robots.txt 한 파일에 집중합니다.
ℹ️ 참고
robots.txt의 Sitemap: 줄에 넣을 사이트맵 파일을 아직 만들지 않았다면 사이트맵 생성 및 제출 가이드 (구글·네이버)를 먼저 확인하세요.
robots.txt란? 크롤러에게 주는 출입 안내문
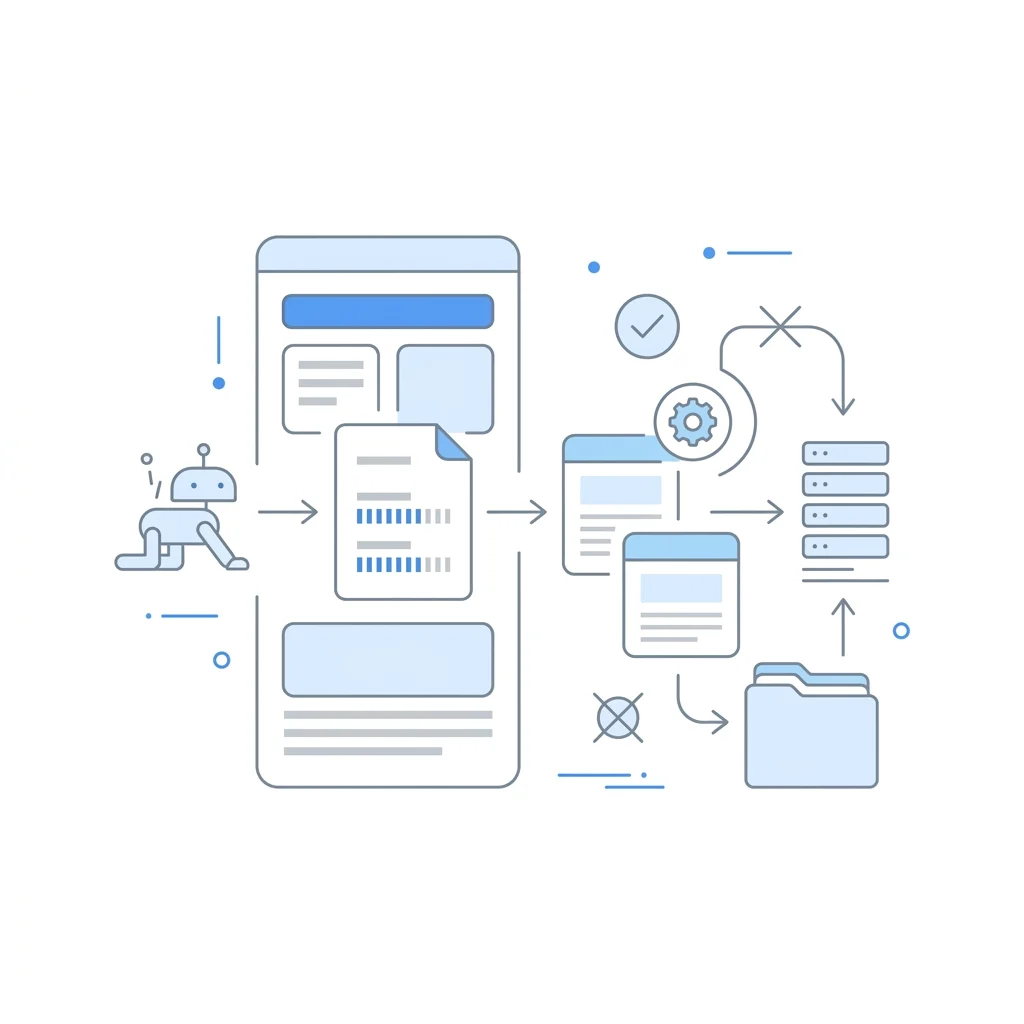
robots.txt는 사이트 루트(예: https://example.com/robots.txt)에 두는 일반 텍스트 파일로, 어떤 크롤러가 어떤 경로를 크롤링해도 되는지를 규칙으로 적어 둡니다. 크롤러는 사이트를 방문하면 가장 먼저 이 파일을 읽고, 적힌 규칙에 따라 수집할 페이지를 고릅니다.
주된 용도는 세 가지입니다.
- 크롤링 낭비 줄이기: 검색 결과 페이지, 필터 조합 URL, 장바구니처럼 검색에 나올 필요가 없는 주소를 크롤러가 반복해서 긁지 않게 합니다.
- 서버 부담 줄이기: 크롤러 요청이 몰려 사이트가 느려지는 상황을 줄입니다.
- 사이트맵 위치 알리기:
Sitemap:줄로 사이트맵 주소를 알려 주면 검색엔진이 페이지 목록을 더 쉽게 찾습니다.
⚠️ 주의
robots.txt는 “요청”이지 “잠금장치”가 아닙니다. 규칙을 지키는 크롤러만 따르고, 파일 자체가 누구에게나 공개됩니다. 관리자 페이지나 고객 정보처럼 숨겨야 하는 주소는 robots.txt에 적지 말고 로그인·비밀번호로 막아야 합니다. 오히려 robots.txt에 적으면 그 경로가 있다는 사실을 알려 주는 셈입니다.
robots.txt 기본 문법: User-agent·Disallow·Allow·Sitemap
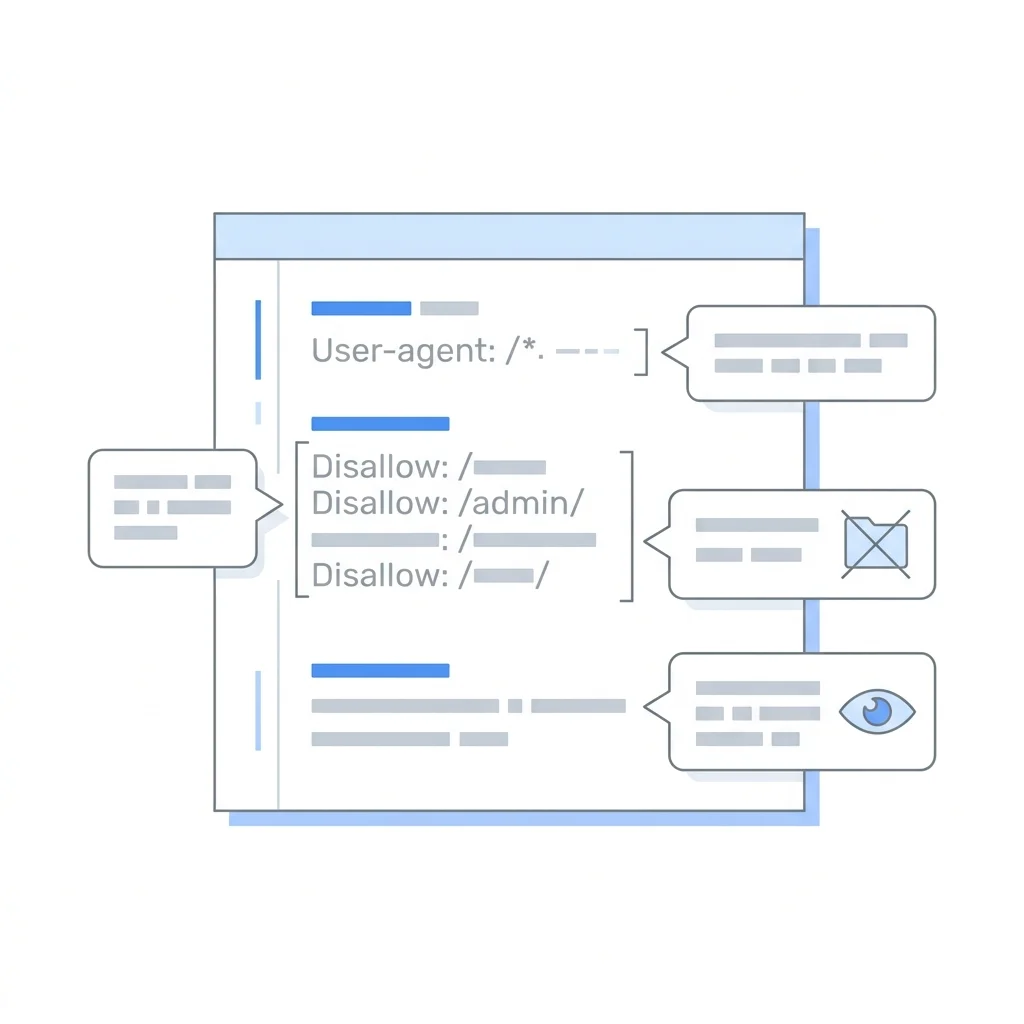
robots.txt는 그룹 단위로 씁니다. 그룹은 User-agent: 줄로 시작하고, 그 아래 Disallow:·Allow: 규칙이 이어집니다. Sitemap: 줄은 그룹과 상관없이 파일 어디에 써도 됩니다.
| 지시어 | 뜻 | 예시 |
|---|---|---|
| User-agent | 규칙을 적용할 크롤러 이름. *는 모든 크롤러 |
User-agent: Googlebot |
| Disallow | 크롤링하지 말 경로 | Disallow: /search/ |
| Allow | Disallow 안에서 예외로 허용할 경로 | Allow: /search/guide.html |
| Sitemap | 사이트맵 전체 주소(https 포함) | Sitemap: https://example.com/sitemap.xml |
작성 규칙 6가지
- 파일 이름과 위치: 반드시 소문자
robots.txt, 도메인 루트에 하나만 둡니다./blog/robots.txt처럼 하위 폴더에 두면 읽지 않습니다. - 인코딩: UTF-8 일반 텍스트로 저장합니다. 워드 프로그램 대신 메모장 같은 텍스트 편집기를 씁니다.
- 대소문자 구분: 경로는 대소문자를 구분합니다.
/File.html과/file.html은 다른 경로입니다. - 와일드카드:
*는 “아무 문자열”,$는 “주소 끝”을 뜻합니다.Disallow: /*.pdf$는 .pdf로 끝나는 모든 주소를 막습니다. - 주석:
#뒤는 무시합니다. 누가 왜 막았는지 적어 두면 나중에 실수를 줄입니다. - 빈 Disallow:
Disallow:뒤를 비우면 “막는 것 없음”이고,Disallow: /는 “전체 차단”입니다. 슬래시 하나 차이가 결과를 정반대로 바꿉니다.
규칙이 겹치면 어떤 것이 이기나
구글은 URL에 맞는 규칙 중 경로가 더 긴(더 구체적인) 규칙을 적용하고, 길이가 같으면 덜 제한적인 규칙(Allow)을 적용합니다. 아래 예시에서 /products/catalog.pdf는 Allow 경로가 더 길어서 크롤링이 허용됩니다.
User-agent: *
Disallow: /products/
Allow: /products/catalog.pdf
또 크롤러는 자기 이름이 적힌 그룹이 있으면 그 그룹만 따르고 User-agent: * 그룹은 무시합니다. Googlebot 전용 그룹을 만들었다면 공통 규칙도 그 그룹 안에 다시 적어야 합니다.
📌 용어 설명: 크롤러(User-agent)
웹페이지를 자동으로 방문해 내용을 수집하는 프로그램입니다. 구글은 Googlebot, 네이버는 Yeti, 빙은 Bingbot이라는 이름을 씁니다. robots.txt의 User-agent 줄에는 이 이름(토큰)을 적습니다.
구글과 네이버는 robots.txt를 어떻게 다르게 읽나
기본 문법(User-agent·Disallow·Allow·Sitemap)은 구글과 네이버가 같게 읽습니다. 차이는 크롤러 이름, 확인 도구, 그리고 일부 비표준 지시어 처리에 있습니다.
| 항목 | 구글 | 네이버 |
|---|---|---|
| 크롤러 이름 | Googlebot | Yeti |
| 확인 도구 | 서치콘솔 설정 > robots.txt 보고서 | 서치어드바이저 웹마스터 도구 > 검증 > robots.txt |
| 파일 크기 상한 | 500KiB (넘는 부분은 무시) | 공식 가이드에 명시 없음 |
| Crawl-delay | 지원하지 않음 | 공식 가이드에 명시 없음 |
구글은 robots.txt 내용을 보통 최대 24시간 동안 캐시합니다. 파일을 고쳐도 하루 정도는 이전 규칙이 적용될 수 있다는 뜻입니다. 급하게 반영해야 하면 서치콘솔 robots.txt 보고서에서 해당 파일 옆 더보기 메뉴의 재크롤링 요청을 누릅니다.
서버 응답도 결과를 바꿉니다. 구글 기준으로 robots.txt 주소가 404 같은 4xx 오류를 내면 “제한 없음”으로 보고 전체를 크롤링합니다. 반대로 5xx 서버 오류가 계속되면 처음 12시간은 크롤링을 멈추고, 이후 30일까지는 마지막으로 받은 파일을 씁니다. robots.txt가 없어서 문제가 되는 경우는 드물지만, 서버 오류는 사이트 전체 크롤링을 멈출 수 있다는 점을 기억하세요.
💡 실무 팁
네이버 서치어드바이저에 사이트를 처음 등록했다면 robots.txt 검증과 사이트맵 제출을 같은 날 함께 처리하세요. 등록 절차는 네이버 웹마스터 도구(서치어드바이저) 등록 방법 단계별 가이드에 정리해 두었습니다.
robots.txt와 noindex는 다릅니다
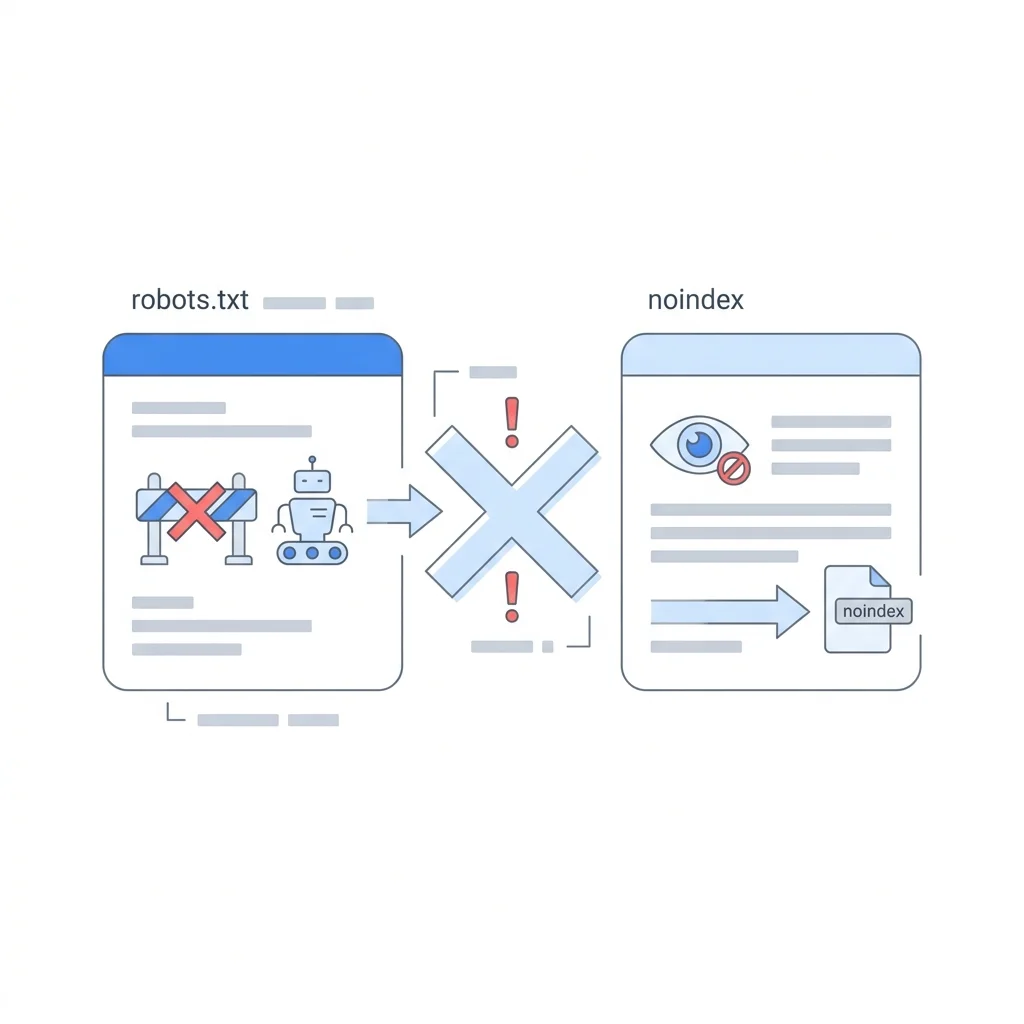
robots.txt는 크롤링(방문)을 막고, noindex는 색인(검색 결과 노출)을 막습니다. 구글 공식 문서도 robots.txt는 페이지가 검색 결과에 나오지 않게 하는 수단이 아니라고 설명합니다. 검색 결과에서 빼려면 noindex를 쓰거나 비밀번호로 보호해야 합니다.
robots.txt로 막은 페이지도 다른 사이트에서 링크를 걸면 주소만 검색 결과에 나올 수 있습니다. 이때는 설명 문구 없이 주소만 표시됩니다. 더 헷갈리는 경우는 둘을 같이 쓸 때입니다. 페이지에 noindex를 넣고 robots.txt로 그 페이지를 막으면, 크롤러가 페이지에 들어가지 못해 noindex 태그를 읽지 못합니다. 결과적으로 검색 결과에서 빠지지 않습니다.
| 하고 싶은 일 | 쓸 도구 |
|---|---|
| 검색 결과에서 특정 페이지 빼기 | 페이지에 <meta name="robots" content="noindex"> (robots.txt로 막지 않기) |
| 필터·검색 결과 주소를 크롤러가 반복 수집하지 않게 하기 | robots.txt Disallow |
| PDF·이미지 같은 파일을 검색에서 빼기 | 서버 응답 헤더 X-Robots-Tag: noindex |
| 내부 자료를 아무도 못 보게 하기 | 로그인·비밀번호 보호 |
noindex 태그를 작성하는 방법은 SEO 메타태그 가이드: 검색 순위에 실제로 영향을 주는 태그 정리를, 이미 색인에서 빠지거나 차단 경고가 뜬 상황이라면 구글 서치콘솔 색인 문제, 종류별 대응 가이드를 참고하세요.
AI 크롤러(GPTBot·Google-Extended·ClaudeBot) 허용할까, 막을까
AI 회사들은 용도별로 크롤러 이름을 나눠 두었습니다. 크게 학습용(모델 학습 데이터 수집), 검색용(AI 검색 답변에 출처로 보여 줄 페이지 수집), 사용자 요청용(사용자가 질문할 때 그 자리에서 페이지를 읽음) 세 종류입니다. 어떤 이름을 막느냐에 따라 결과가 다릅니다.
| 회사 | User-agent | 용도 | 막으면 |
|---|---|---|---|
| OpenAI | GPTBot | 모델 학습 | 학습 데이터에서 제외 |
| OpenAI | OAI-SearchBot | ChatGPT 검색 | ChatGPT 검색 답변에 나오지 않음(이동용 링크는 나올 수 있음) |
| OpenAI | ChatGPT-User | 사용자 요청 시 열람 | 사용자 요청 기반이라 robots.txt가 적용되지 않을 수 있음 |
| Google-Extended | Gemini 학습·그라운딩 | Gemini 학습·그라운딩에서 제외. 구글 검색 노출·순위에는 영향 없음 | |
| Anthropic | ClaudeBot | 모델 학습 | 이후 학습 데이터에서 제외 |
| Anthropic | Claude-SearchBot | Claude 검색 품질 | Claude 검색 결과 노출이 줄어듦 |
| Anthropic | Claude-User | 사용자 요청 시 열람 | 사용자 질문에 답할 때 페이지를 못 읽음 |
| Perplexity | PerplexityBot | Perplexity 검색 결과 노출 | Perplexity 검색 결과에서 빠짐(학습용 아님) |
각 회사 공식 문서 기준(2026-10-01 확인)입니다. 크롤러 이름과 용도는 바뀔 수 있으니 설정 전에 OpenAI 크롤러 문서, Google 일반 크롤러 목록, Anthropic 크롤러 안내를 다시 확인하세요.
기업 홈페이지라면 이렇게 판단합니다
- 제품·서비스를 알리는 회사 소개 사이트: 검색용 크롤러(OAI-SearchBot·Claude-SearchBot·PerplexityBot)는 열어 두는 편이 유리합니다. 고객이 ChatGPT나 Perplexity에 “○○ 장비 제조사”를 물었을 때 출처 후보에 오를 기회가 생기기 때문입니다. 다만 열어 둔다고 인용이 보장되지는 않습니다.
- 학습용 크롤러(GPTBot·ClaudeBot·Google-Extended): 자체 연구 자료, 유료 콘텐츠, 저작권이 민감한 원고가 많다면 막는 것을 검토합니다. 회사 소개와 제품 안내가 대부분이라면 막아도 얻는 것이 크지 않습니다.
- 한 이름만 막으면 나머지는 그대로입니다: ClaudeBot을 막아도 Claude-SearchBot과 Claude-User는 막히지 않습니다. 이름마다 따로 적어야 합니다.
⚠️ 주의
Google-Extended를 막는다고 구글 검색에서 빠지지 않습니다. 반대로 Googlebot을 막으면 구글 검색 전체에서 빠질 수 있습니다. “구글 AI가 싫어서” Googlebot을 막는 실수가 실제로 자주 나옵니다.
기업 홈페이지 robots.txt 예시 파일
아래는 회사 소개·제품 소개·게시판·관리자 페이지가 있는 일반적인 기업 홈페이지 기준 예시입니다. 경로는 사이트 구조에 맞게 바꿔 쓰세요.
# 기본 규칙: 모든 크롤러
User-agent: *
Disallow: /admin/          # 관리자 화면 (로그인 보호는 별도로 필수)
Disallow: /search          # 사이트 내부 검색 결과
Disallow: /*?sort=         # 정렬 조합 주소
Disallow: /*?filter=       # 필터 조합 주소
Allow: /

# 학습용 AI 크롤러만 차단하는 경우 (선택)
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /

Sitemap: https://www.example.com/sitemap.xml
여러 User-agent 줄을 연달아 쓰면 그 아래 규칙이 모두에게 적용됩니다. 학습용 크롤러를 막을 생각이 없다면 두 번째 그룹은 지웁니다.
워드프레스 사이트라면
워드프레스는 실제 파일이 없어도 /robots.txt 주소에 기본 규칙(관리자 폴더 차단 등)을 자동으로 보여 줍니다. SEO 플러그인이 내용을 덮어쓰는 경우도 많습니다. 수정하기 전에 브라우저로 도메인/robots.txt를 열어 현재 적용 중인 내용을 먼저 확인하고, 어느 경로(플러그인 설정·실제 파일)에서 관리되는지 정한 뒤 한 곳에서만 고치세요.
robots.txt 흔한 실수 5가지
1. 개발 서버 설정을 그대로 운영에 올리기
제작 중인 시안 사이트는 검색에 나오면 안 되므로 Disallow: /로 전체를 막아 둡니다. 문제는 오픈할 때 이 파일을 그대로 옮기는 경우입니다. 그러면 새 사이트가 몇 주 동안 검색에 나오지 않습니다. 오픈 당일 도메인/robots.txt를 직접 열어 Disallow: /가 남아 있지 않은지 확인하세요. 시안 서버를 robots.txt가 아니라 서버 응답 헤더(X-Robots-Tag: noindex)나 접속 제한으로 막아 두면 이 사고를 구조적으로 피할 수 있습니다.
2. CSS·JS 폴더 차단
구글은 페이지를 실제 브라우저처럼 그려 보고 평가합니다. 스타일·스크립트 폴더를 막으면 페이지가 깨진 상태로 보일 수 있습니다. 테마·플러그인 폴더 전체를 막는 오래된 예시를 그대로 쓰지 마세요.
3. 숨기고 싶은 페이지를 robots.txt로 막기
앞서 설명했듯 robots.txt는 색인을 막지 못하고, 파일 내용이 공개됩니다. 숨길 페이지는 noindex나 로그인 보호를 씁니다.
4. 경로 대소문자·끝 슬래시 실수
Disallow: /Admin은 /admin을 막지 않습니다. Disallow: /blog는 /blog-news까지 막습니다(앞부분이 같으면 일치). 폴더만 막으려면 /blog/처럼 끝에 슬래시를 붙입니다.
5. 도메인마다 파일이 따로라는 점을 잊기
robots.txt는 프로토콜·호스트 단위로 적용됩니다. www.example.com과 shop.example.com은 각자 robots.txt가 필요합니다. 쇼핑몰이나 채용 사이트를 하위 도메인으로 운영한다면 그쪽 파일도 확인하세요.
작성 후 확인하는 방법
- 브라우저로 열기:
https://도메인/robots.txt를 열어 파일이 그대로 보이는지 확인합니다. 로그인 화면이나 404가 뜨면 위치가 잘못된 것입니다. - 구글 서치콘솔: 설정 > robots.txt 보고서에서 구글이 마지막으로 가져온 시간, 상태, 문법 경고를 봅니다. 사용법은 구글 서치콘솔 사용법 핵심 기능별 가이드에 있습니다.
- URL 검사: 중요한 페이지 몇 개를 서치콘솔 URL 검사에 넣어 “robots.txt에 의해 차단됨”이 뜨지 않는지 봅니다.
- 네이버 서치어드바이저: 웹마스터 도구의 robots.txt 검증 기능으로 Yeti가 파일을 읽을 수 있는지 확인합니다.
자주 묻는 질문
robots.txt가 없으면 어떻게 되나요?
구글 기준으로 robots.txt 주소가 404를 내면 “제한 없음”으로 보고 사이트 전체를 크롤링합니다. 막을 경로가 없는 작은 사이트라면 큰 문제는 없지만, 사이트맵 위치를 알려 주기 위해서라도 만들어 두는 편이 좋습니다.
robots.txt를 고치면 바로 반영되나요?
구글은 보통 최대 24시간 동안 이전 파일을 캐시합니다. 급하면 서치콘솔 robots.txt 보고서에서 재크롤링을 요청합니다. 이미 색인된 페이지가 검색 결과에서 사라지는 데는 이보다 더 오래 걸립니다.
Crawl-delay를 넣으면 구글 크롤링 속도가 줄어드나요?
아닙니다. 구글은 Crawl-delay를 지원하지 않습니다. 일부 다른 크롤러(예: Anthropic)는 지원한다고 밝히고 있습니다.
AI 검색에 나오려면 robots.txt만 열어 두면 되나요?
robots.txt는 출입을 허락할 뿐입니다. 인용 여부는 본문이 질문에 직접 답하는지, 페이지가 자바스크립트 없이도 읽히는지, 구조화 데이터와 사이트맵이 정리돼 있는지 같은 요소에 더 크게 좌우됩니다.
웹닷은 시안 서버 차단, 운영 오픈 시 robots.txt·사이트맵 전환, AI 크롤러 정책을 빌드 단계에서 함께 처리합니다.
정리
- robots.txt는 도메인 루트에 두는 UTF-8 텍스트 파일이며, User-agent·Disallow·Allow·Sitemap 네 줄로 대부분을 처리합니다.
- 규칙이 겹치면 구글은 더 긴 경로의 규칙을, 길이가 같으면 Allow를 적용합니다.
- robots.txt는 크롤링을 막을 뿐 색인을 막지 못합니다. 검색 결과에서 빼려면 noindex, 숨기려면 로그인 보호를 씁니다.
- AI 크롤러는 학습용·검색용·사용자 요청용으로 이름이 나뉩니다. 기업 홈페이지는 검색용을 열어 두고 학습용은 콘텐츠 성격에 따라 판단합니다.
- 오픈 당일
Disallow: /가 남아 있지 않은지 반드시 확인하고, 서치콘솔 robots.txt 보고서로 검증합니다.